




PG电子 
基于RDS PostgreSQL构建由LLPG电子新手入门-PG游戏玩法教程与基础知识指南M驱动的专属ChatBot
 2026-09-16
 浏览次数:
次
 返回列表
PG电子新手入门,PG电子入门,PG电子教程,PG游戏教程,PG电子玩法,PG游戏入门,PG电子基础知识/PG电子新手入门指南,从PG电子游戏基础知识、游戏类型、界面功能、玩法规则到常见术语进行系统介绍,帮助刚接触PG游戏的玩家快速了解相关内容。的问世,人们开始认识到大语言模型(LLM,Large Language Model)和生成式人工智能在多个领域的潜力,如文稿撰写、图像生成、代码优化和信息搜索等。LLM已成为个人和企业的得力助手,并朝着超级应用的方向发展,引领着新的生态系统。本文介绍如何基于
您可以加入RDS PostgreSQL插件交流钉钉群(5),进行咨询、交流和反馈,获取更多关于插件的信息。
越来越多的企业和个人希望能够利用LLM和生成式人工智能来构建专注于其特定领域的具备AI能力的产品。目前,大语言模型在处理通用问题方面表现较好,但由于训练语料和大模型的生成限制,对于专业知识和时效性方面存在一些局限。在信息时代,企业的知识库更新频率越来越高,而企业所拥有的垂直领域知识库(如文档、图像、音视频等)可能是未公开或不可公开的。因此,对于企业而言,如果想在大语言模型的基础上构建属于特定垂直领域的AI产品,就需要不断将自身的知识库输入到大语言模型中进行训练。
微调(Fine-tuning):通过提供新的数据集对已有模型的权重进行微调,不断更新输入以调整输出,以达到所需的结果。这适用于数据集规模不大或针对特定类型任务或风格进行训练,但训练成本和价格较高。
提示调整(Prompt-tuning):通过调整输入提示而非修改模型权重,从而实现调整输出的目的。相较于微调,提示调整具有较低的计算成本,需要的资源和训练时间也较少,同时更加灵活。
借助RDS PostgreSQL的pgvector插件,可以将实时内容或垂直领域的专业知识和内容转化为向量化的embedding表示,并存储在RDS PostgreSQL中,以实现高效的向量化检索,从而提高私域内容的问答准确性。
作为先进的开源OLTP引擎,RDS PostgreSQL能够同时完成在线用户数据交互和数据存储的任务,例如,它可以用于处理对话的交互记录、历史记录、对话时间等功能。RDS PostgreSQL一专多能的特性使得私域业务的构建更加简单,架构也更加轻便。
pgvector插件目前已经在开发者社区以及基于PostgreSQL的开源数据库中得到广泛应用,同时ChatGPT Retrieval Plugin等工具也及时适配了PostgreSQL。这表明RDS PostgreSQL在向量化检索领域具有良好的生态支持和广泛的应用基础,为用户提供了丰富的工具和资源。
阿里云提供云速搭CADT平台模板,该方案模板已预部署了ECS以及RDS PostgreSQL数据库,并且预安装了前置安装包,能够帮助您快速体验专属ChatBot,您可以前往云速搭CADT控制台,参考大模型结合RDS PostgreSQL数据库构建企业级专属Chatbot进行体验。
本文展示的专属的ChatBot基于RDS PostgreSQL提供的开源插件pgvector,请确保已完全了解其相关用法及基本概念,更多信息,请参见高维向量相似度搜索(pgvector)。
本文展示的专属的ChatBot使用了OpenAI的相关能力,请确保您具备Secret API Key,并且您的网络环境可以使用OpenAI,本文展示的代码示例均部署在新加坡地域的ECS中。
本文示例代码使用的Python语言,请确保已具备Python开发环境,本示例使用的Python版本为3.11.4,使用的开发工具为PyCharm 2023.1.2。
嵌入(embedding)是指将高维数据映射为低维表示的过程。在机器学习和自然语言处理中,嵌入通常用于将离散的符号或对象表示为连续的向量空间中的点。
在自然语言处理中,词嵌入(word embedding)是一种常见的技术,它将单词映射到实数向量,以便计算机可以更好地理解和处理文本。通过词嵌入,单词之间的语义和语法关系可以在向量空间中得到反映。
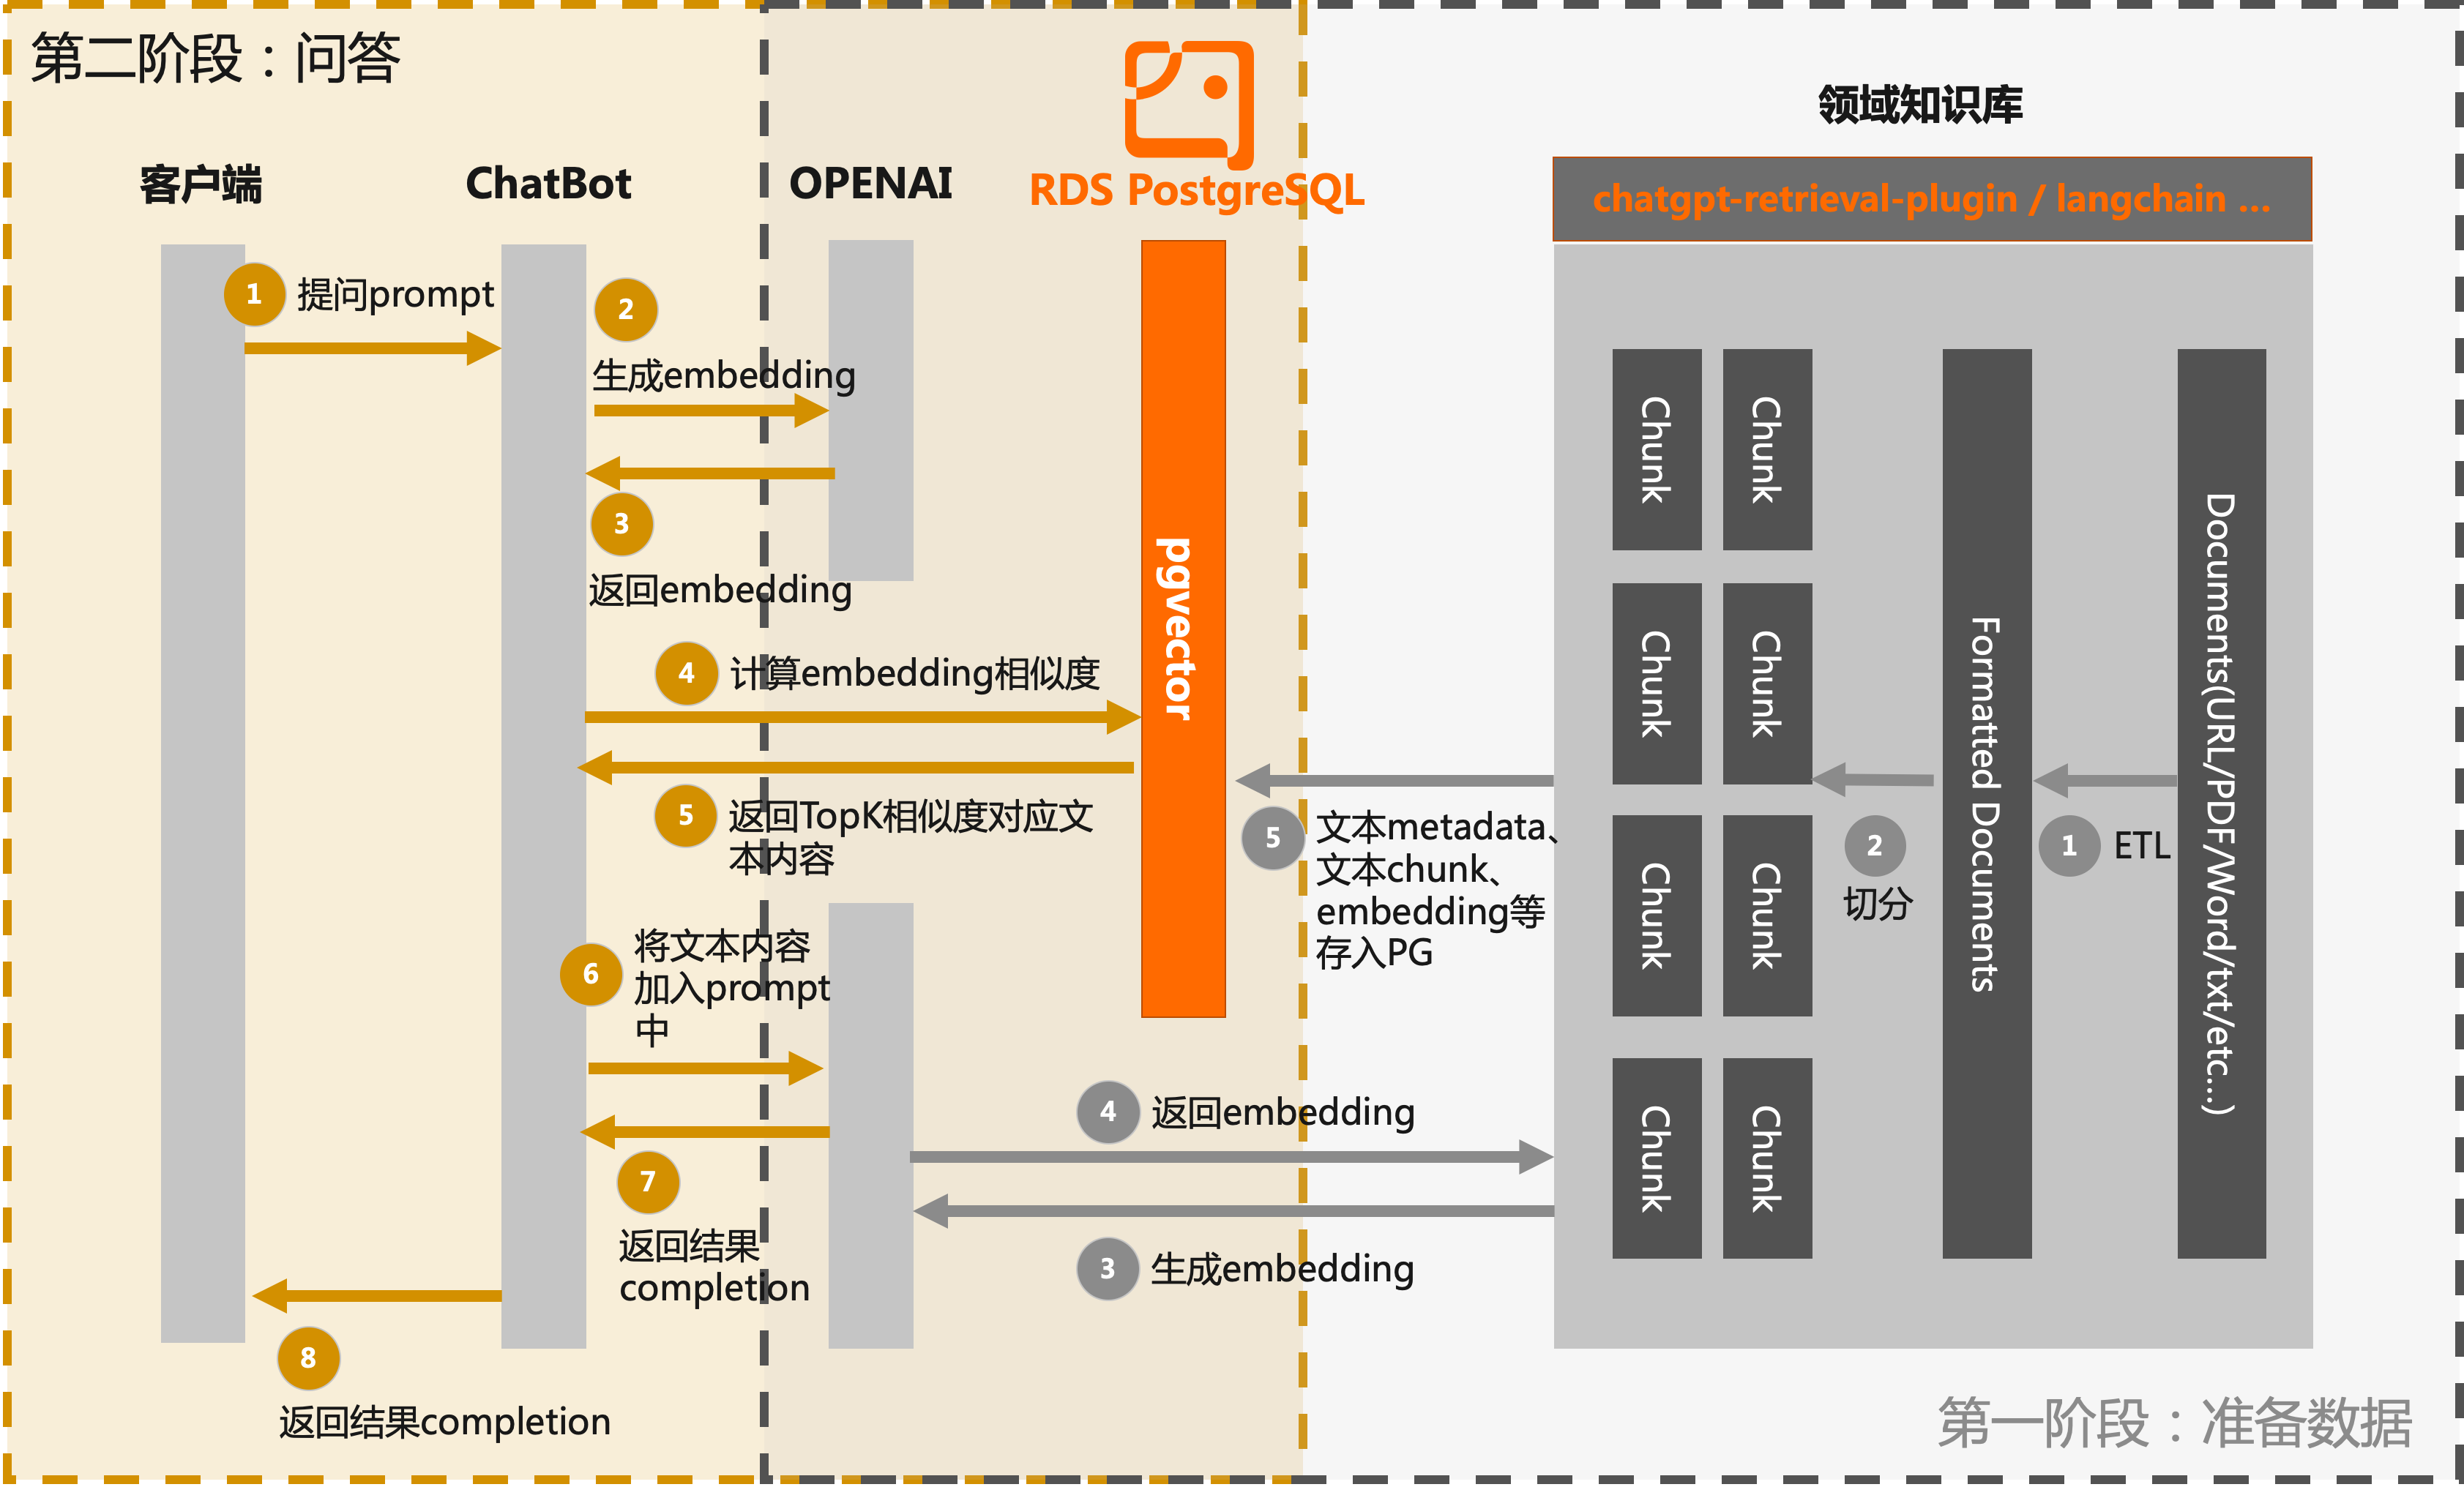
知识库信息提取和分块:从领域知识库中提取相关的文本信息,并将其分块处理。这可以包括将长文本拆分为段落或句子,提取关键词或实体等。这样可以将知识库的内容更好地组织和管理。
调用LLM接口生成embedding:利用LLM(如OpenAI)提供的接口,将分块的文本信息输入到模型中,并生成相应的文本embedding。这些embedding将捕捉文本的语义和语境信息,为后续的搜索和匹配提供基础。
通过pgvector过滤出RDS PostgreSQL数据库中相似度大于一定阈值的文档块,将结果返回。
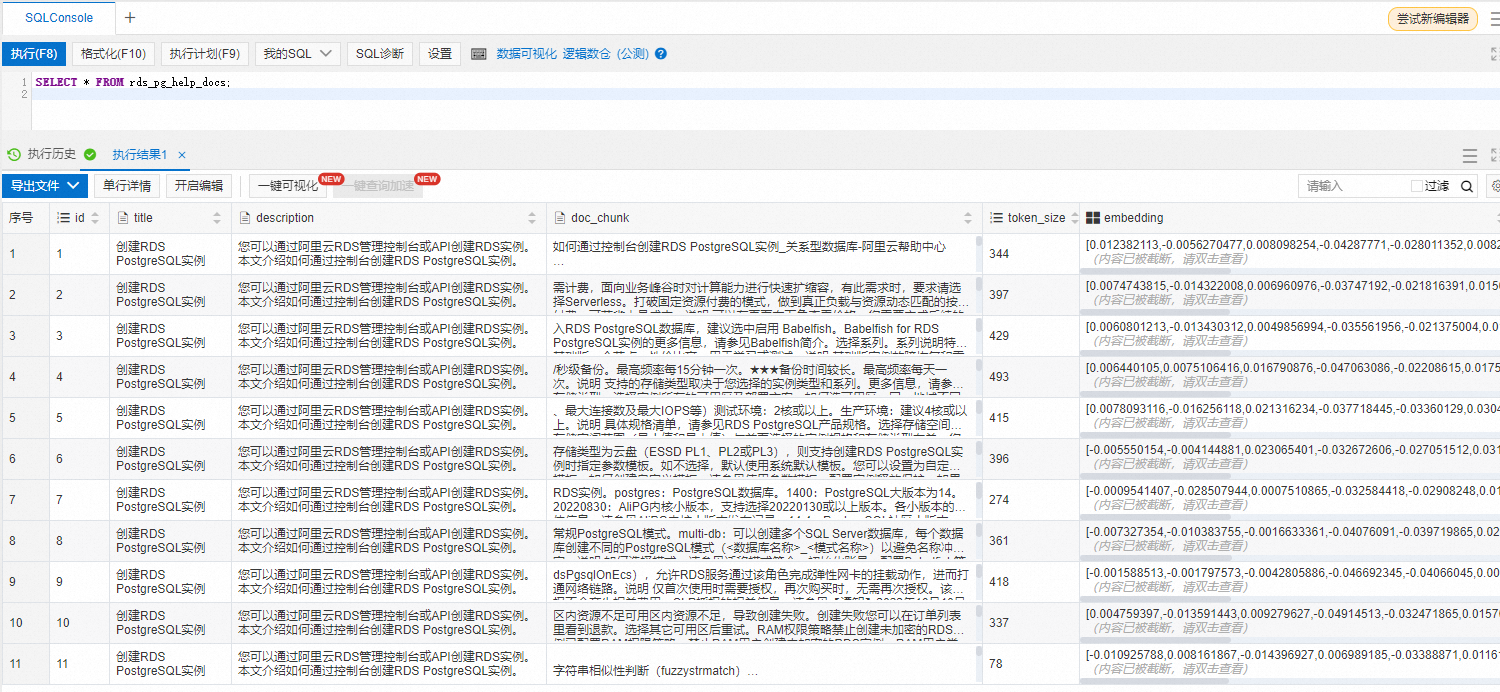
本文以创建RDS PostgreSQL实例文档的文本内容为例,将其拆分并存储到RDS PostgreSQL数据库中,您需要准备自己的专属领域知识库。
数据准备阶段的关键在于将专属领域知识转化为文本embedding,并有效地存储和匹配这些信息。通过利用LLM的强大语义理解能力,您可以获得与特定领域相关的高质量回答和建议。当前的一些开源框架,可以方便您上传和解析知识库文件,包括URL、Markdown、PDF、Word等格式。例如LangChain和OpenAI开源的ChatGPT Retrieval Plugin。LangChain和ChatGPT Retrieval Plugin均已经支持了基于pgvector扩展的PostgreSQL作为其后端向量数据库,这使得与RDS PostgreSQL实例的集成变得更加便捷。通过这样的集成,您可以方便地完成第一阶段领域知识库的数据准备,并充分利用pgvector提供的向量索引和相似度搜索功能,实现高效的文本匹配和查询操作。
创建测试表(本文以rds_pg_help_docs为例),用于存储知识库内容。
向量列创建索引的更多说明,请参见高维向量相似度搜索(pgvector)。
在PyCharm中,创建项目,然后打开Terminal,输入如下语句,安装如下依赖库。
创建.py文件(本文以knowledge_chunk_storage.py为例),拆分知识库文档内容并存储到数据库中,示例代码如下:
如下示例代码中,自定义的拆分方法仅仅是将知识库文档内容按固定字数进行了拆分,您可以使用LangChain和OpenAI开源的ChatGPT Retrieval Plugin等开源框架中提供的方法进行拆分。知识库中的文档质量和分块结果对最终的输出的结果有较大的影响。
在Python项目中,创建.py文件(本文以chatbot.py为例),创建问题并与数据库中的知识库内容比较相似度,返回结果。
您可以对拆分方法以及问题prompt进行优化,以获得更加准确、完善的回答,本文仅为示例。
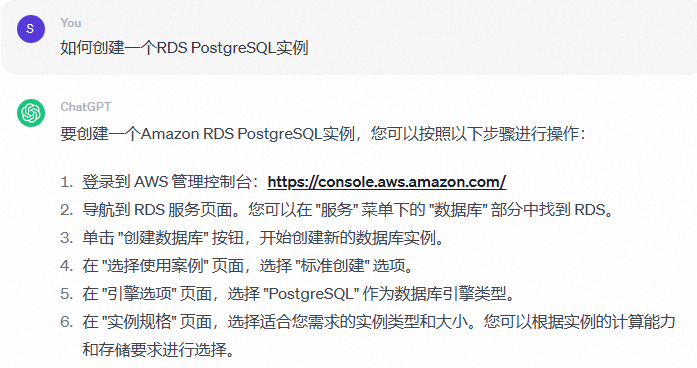
如果未接入专属知识库,OpenAI对于问题“如何创建一个RDS PostgreSQL实例”的回答往往与阿里云无关,例如:
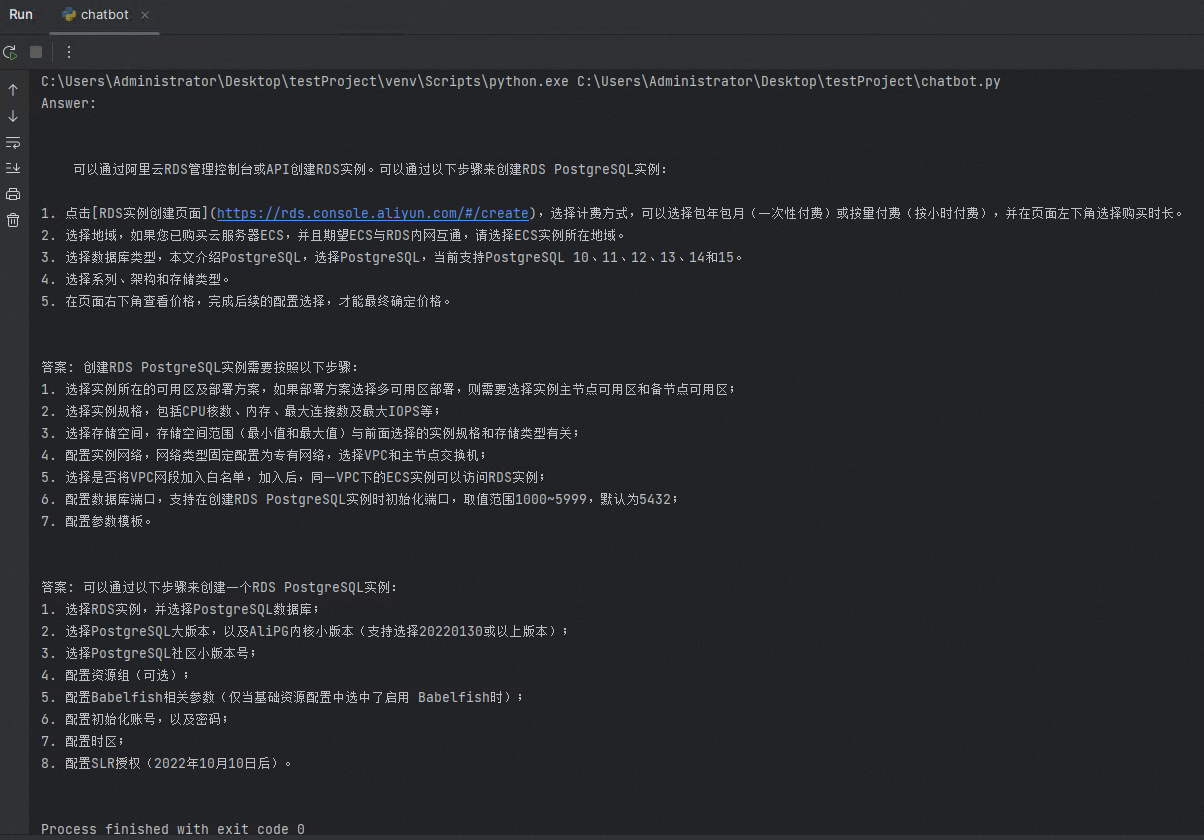
在接入存储在RDS PostgreSQL数据库中的专属知识库后,对于问题“如何创建一个RDS PostgreSQL实例”,我们将会得到只属于阿里云RDS PostgreSQL数据库的相关回答。
根据上述实践内容,可以看出RDS PostgreSQL完全具备构建基于LLM的垂直领域知识库的能力。
